§01Contributions
동시 편집 환경에서 데이터 정합성 보장
  • 동시 수정시 낙관적 락을 통한 동시성 관리 및 편집 이벤트 트래킹을 통한 수정 중인 데이터 삭제 차단
  • 사용자 간 편집 충돌로 인한 데이터 손실 가능성 감소
요구 사항 분석과 기획 및 구현
  • 복잡한 IEC 61850 규정을 분석하여 사용자가 국제 표준을 깊이 이해하지 않아도 표준에 맞는 파일을 생성하고 수정할수 있는 파일 편집기 기획 및 개발
CI 기반 자동 품질 검증 환경 구축
  • PR 생성 시 자동 테스트를 수행하여 회귀 오류를 사전에 검증
  • GitHub Copilot Code Review를 활용해 코드 리뷰를 자동화하고 피드백을 반영하여 코드 품질 향상
§02Problem Solving
PS-01임베디드 DB를 영속 저장소로 볼 것인가, 세션 작업 저장소로 볼 것인가
문제 상황

이 어플리케이션은 별도 DB 서버 설치 없이 애플리케이션에 내장되는 무설치 배포가 요구사항이라, 경량 임베디드 DB(H2·SQLite)가 후보였다. 동시에 이 도메인의 최종 산출물이자 영구 데이터는 편집한 xml 파일 자체이고, DB는 편집 세션 동안 xml 파일의 노드 트리(124개 테이블 규모)를 다루기 위한 저장소일 뿐이었다. 즉 "DB를 영구저장소로 볼 것인가, 세션용 작업 저장소로 볼 것인가"를 결정해야 하는 상황이었다.

이 결정을 앞당긴 건 구체적인 실패였다. SQLite를 사용해 124개 테이블 규모의 스키마를 `ddl-auto: update` 설정으로 영속화한 상태에서 애플리케이션을 부팅하자, SessionFactory 빌드 단계에서 `[SQLITE_ERROR] too many terms in compound SELECT` 오류가 발생했다. 해당 환경에서는 정상적인 부팅이 어려워 SQLite를 사용할 수 없었고, 결국 H2 DB로 변경했다. 이 실패는 단순한 DB 교체를 넘어, "DB의 역할을 무엇으로 규정할 것인가"라는 질문을 강제했다.
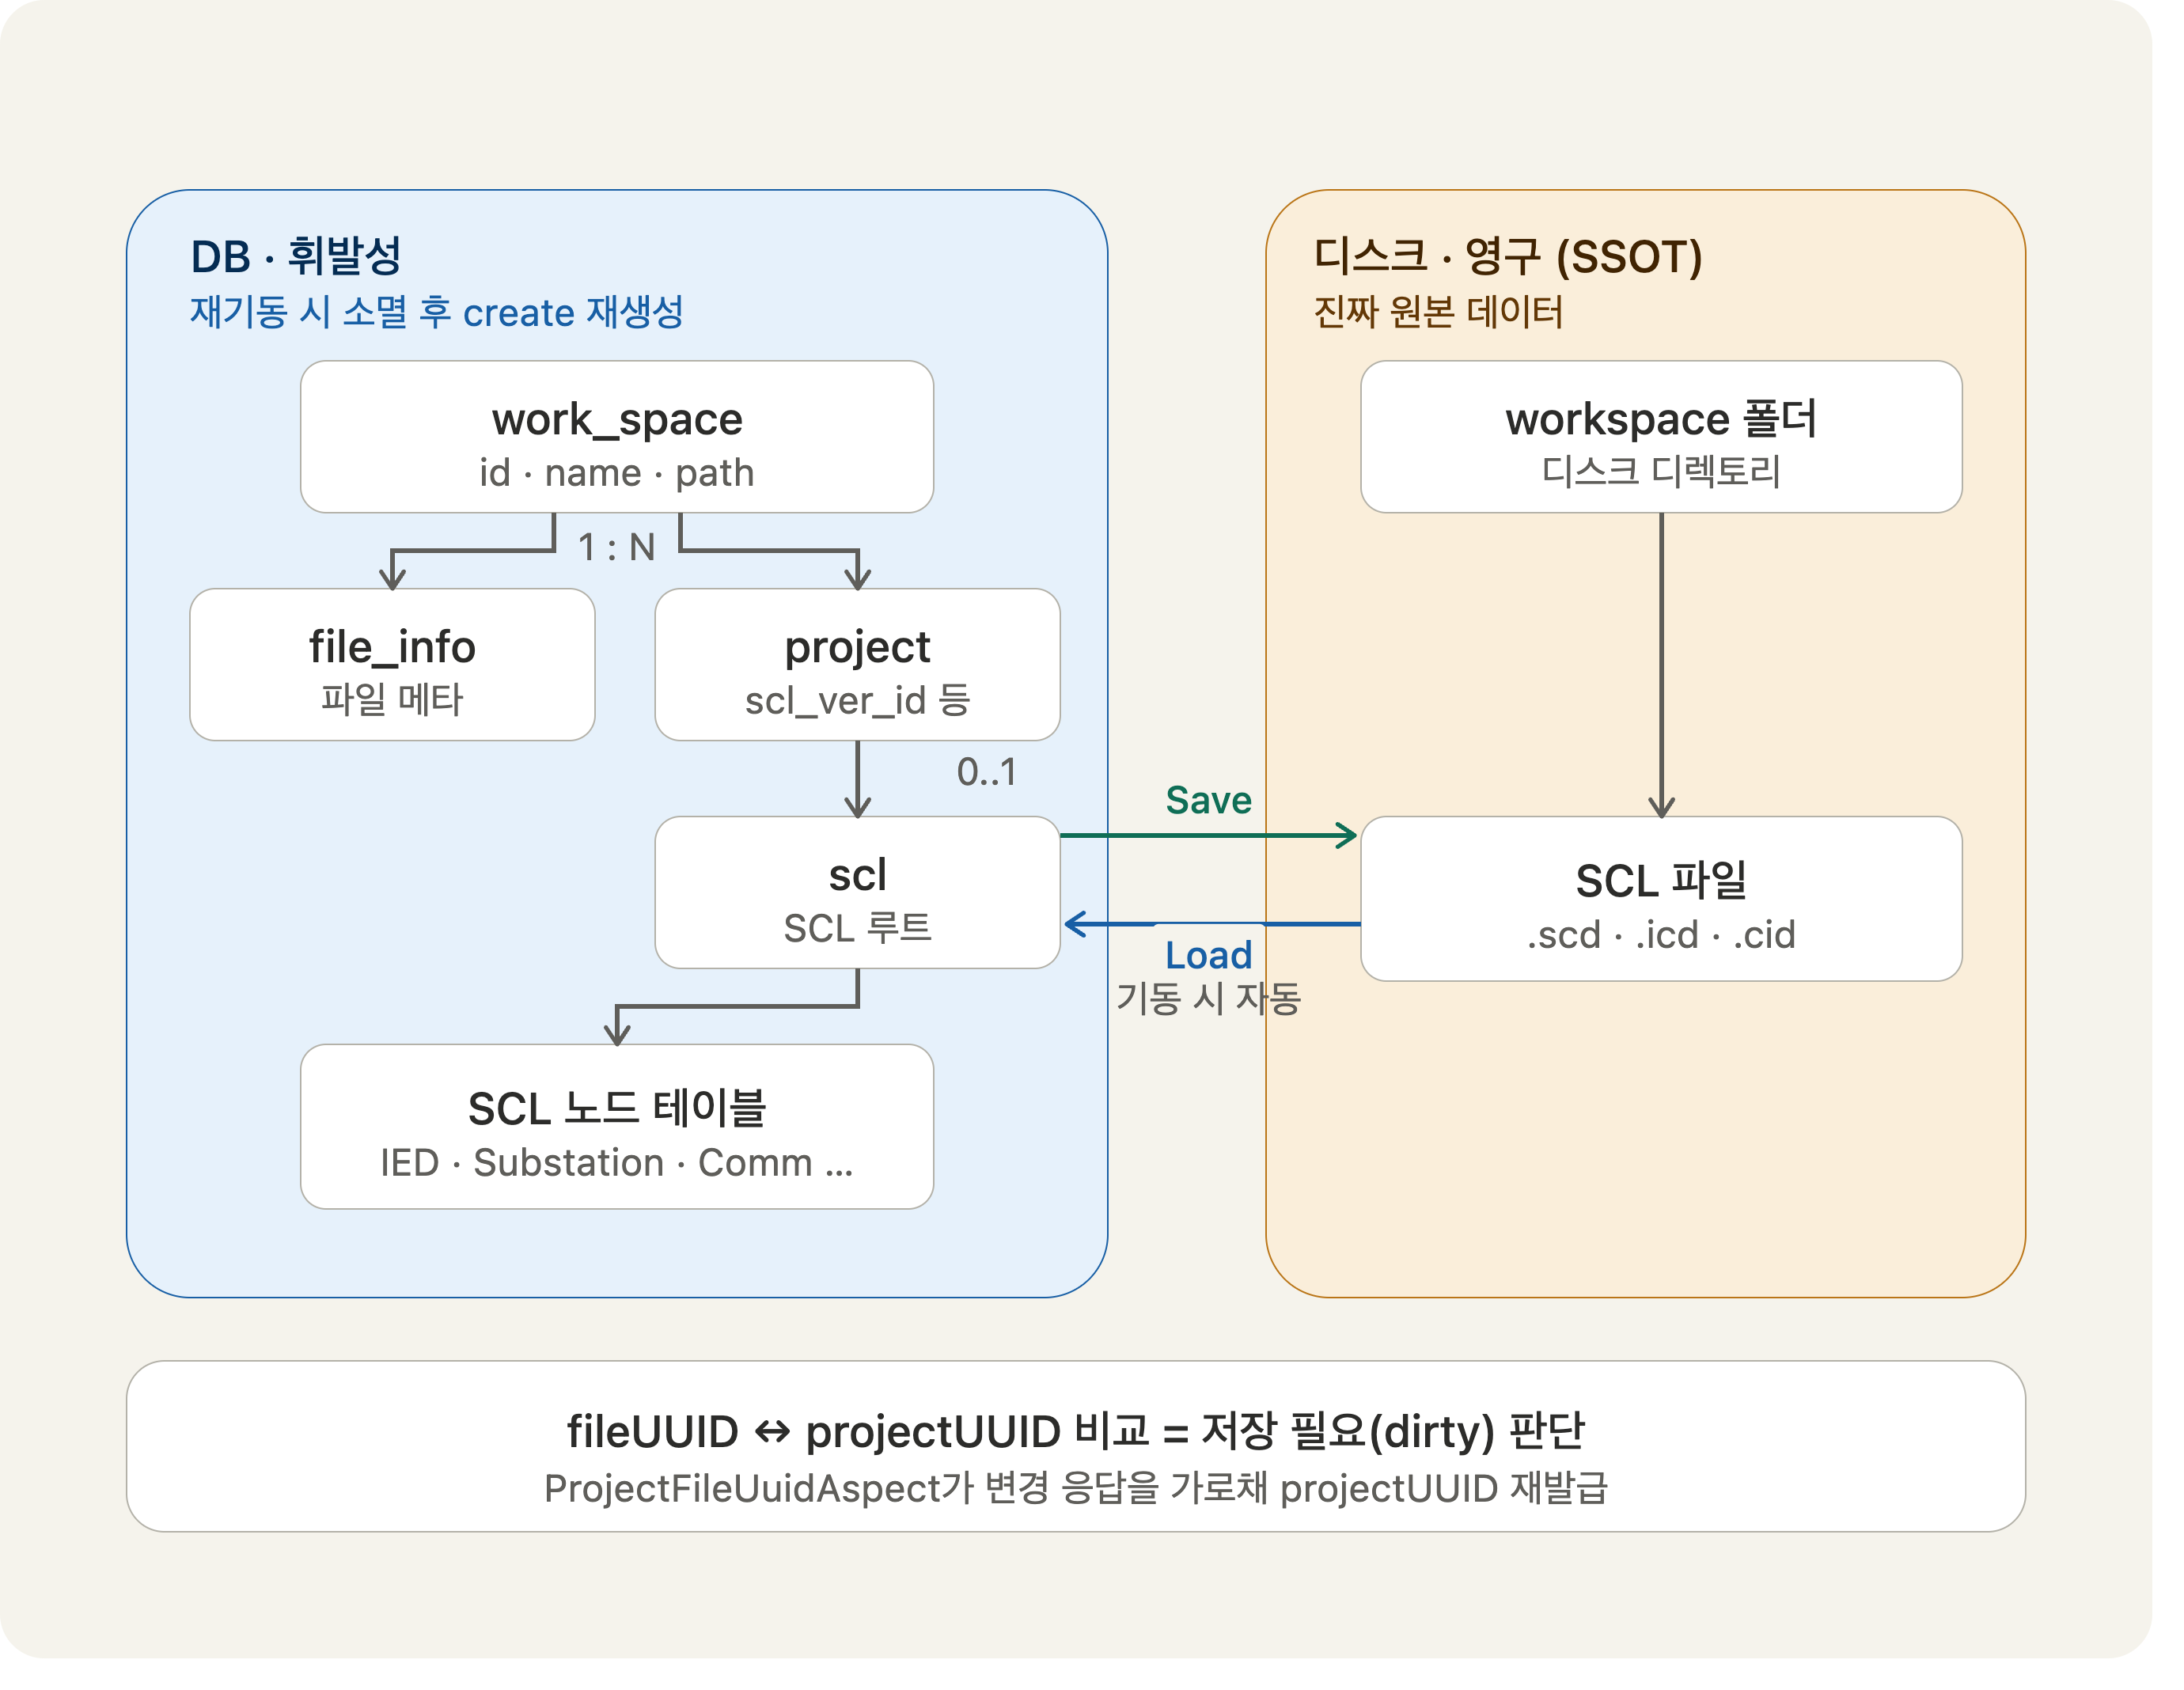
분석
파일 시스템을 영구 저장소로, 임베디드 DB를 편집 세션용 작업 저장소로 이원화한 아키텍처 구성도
이 어플리케이션의 진짜 영구 데이터는 DB가 아니라 파일 자체라는 점을 생각해 DB는 편집 세션 동안 xml 파일의 노드 트리를 CRUD하기 위한 작업 저장소로 여길 수도 있겠다는 판단이 들었다. 즉 영구 데이터는 파일로 관리하고, DB는 휘발성으로 규정해도 데이터 손실 위험이 없다고 결론을 내렸다. 또한 영구 데이터를 DB가 아니라 파일로 관리하면, 사용자가 편집 내용을 파일로 export하고 싶어 할 때 영구 저장소에 존재하는 파일을 그대로 떨궈주기만 하면 되어 매번 DB의 정보를 기반으로 파일을 생성하지 않아도 되므로 캐싱 효과까지 있을 것이라는 판단이 들었다.
구현ddl-auto: create로 DB 스키마를 재기동시 매번 초기화 하도록 확정, 영구 저장소는 파일 시스템으로 이원화 함.
  • 서버 기동: workspace 디렉토리를 스캔해 워크스페이스 정보를 DB에 등록하고, 각 워크스페이스에 존재하는 파일들의 파일 경로, 생성일 등의 메타데이터를 함께 DB에 등록.

  • 파일 불러오기 : 파일 시스템에 존재하는 파일을 읽어 DB에 파일 내용을 insert

  • 파일 ↔ DB 불일치 체크 : create/update/delete 컨트롤러를 AOP로 가로채 파일의 수정이 일어날 시 project의 UUID 재발급 → fileUUID와 비교해 DB와 파일 저장소의 파일의 불일치 여부를 판단하여 사용자에게 알림.

  • Save : 사용자가 화면에서 저장 버튼을 클릭한 시점에만 DB의 파일 내용을 파일 시스템에 반영하고, 사용자가 지정한 폴더 경로에 파일을 생성. 자동 저장은 지원하지 않음.
결과DB 무설치 단일 배포라는 제약을 지키면서 단순한 에러 회피를 넘어 도메인과 정합적인 저장 아키텍처를 얻게 되었다.
  • 이중 저장소 정합성 문제 제거 — 파일을 유일한 정답 데이터로 취급하여 DB를 영속화 했을 때 발생할 파일 ↔ DB 상태 불일치와 동기화 문제를 없앰.

  • 스키마 마이그레이션·드리프트 관리 제거 — 매 기동 create로 스키마를 재생성해, 124개 테이블이 항상 현재 엔티티 정의와 일치. 마이그레이션 스크립트·버전 관리 부담이 사라졌다.

  • 백업 단순화 — 매 기동 깨끗한 스키마로 시작해 임베디드 DB에 상태가 누적·손상될 여지가 없고, 백업/보호 대상이 DB가 아닌 파일 폴더로 단순화됐다.
PS-02예외를 catch 했는데도 트랜잭션이 롤백되는 문제
문제 상황별도 트랜잭션 빈에서 발생한 예외를 잡아 로그만 남기고 정상 흐름을 이어갔는데, 정작 상위 트랜잭션 커밋 시점에 롤백 관련 예외(UnexpectedRollbackException)가 발생했다.
원인예외를 던진 쪽이 별도 트랜잭션 경계를 가진 빈이라 예외 발생 시 트랜잭션이 이미 rollback-only로 마킹됐는데, 호출한 쪽이 try-catch로 catch 구문에서 로그만 남기고 그 예외를 삼키는 바람에 실제 트랜잭션 상태와 예외 흐름이 어긋난 것이 원인이었다.
해결 방법예외를 삼키지 않고 그대로 위로 전파하도록 수정해, 트랜잭션의 롤백 상태와 예외 흐름을 일치시켰다. Propagation.REQUIRES_NEW를 이용해 트랜잭션을 분리한 부분 커밋 방법도 고려해 봤지만, 다중 사용자 환경에서 동시성이슈가 있을 것 같아 전체 롤백 시키는 정책을 채택했다.
핵심 교훈하위 작업에서 실패를 같은 트랜잭션 내에서 삼키는 것은 불가능 하고, 만약 동시성 이슈의 가능성이 있는 상황이라면 데이터 정합성을 위해 전체 롤백 정책을 고려해 봐야 할 수 있다는 것을 배움.
PS-03엔티티 하나 조회에 상위 테이블 10개 이상이 딸려오는 문제
문제 상황여러 엔티티가 부모-자식 관계로 깊게 연결된 트리 구조에서 가장 말단에 있는 데이터 하나만 조회 했을 뿐인데 연결된 상위 부모 엔티티까지 전부 조인 되는 문제 발생.
원인연관관계 기본 설정을 그대로 사용하여 즉시 로딩(EAGER)되고 있었음.
해결 방법연관관계를 지연 로딩(LAZY)로 변경. 연관관계의 데이터가 실제로 필요한 조회에서는 fetch join으로 필요할 때만 데이터를 가져오도록 구현. 지연 로딩만 쓸 때 발생 할 수 있는 N+1 조회 문제를 예방
핵심 교훈연관관계는 기본적으로 지연 로딩으로 두고, 데이터가 실제로 필요한 시점에만 명시적으로 함께 가져오는 것이 좋음.